一分钟说清GEO,程序员四步搞定优化,让AI读到数据
不知道你发现没有:身边人遇到问题,第一反应已经不是打开搜索引擎,而是直接问AI。"XX工具怎么选?""这个领域哪家靠谱?"AI的回答,正在变成新的流量入口。
这就带来一个很现实的问题:当用户问到你所在的领域,AI提不提你?
你可以先做个一分钟自测:打开任意一个主流AI助手,问一句你行业里的典型问题,看看回答里有没有你或你的产品。如果没有,别急着怀疑自己做得不好,大概率是AI根本"看"不见你。
这正是最近很火的**GEO(Generative Engine Optimization,生成式引擎优化)**解决的问题。好消息是,它对程序员来说,不是玄学,是工程活。
原理:AI是个开卷考试的学生
AI回答问题的方式,像极了开卷考试的学生:先翻资料,再抄笔记,最后组织成自己的答案。
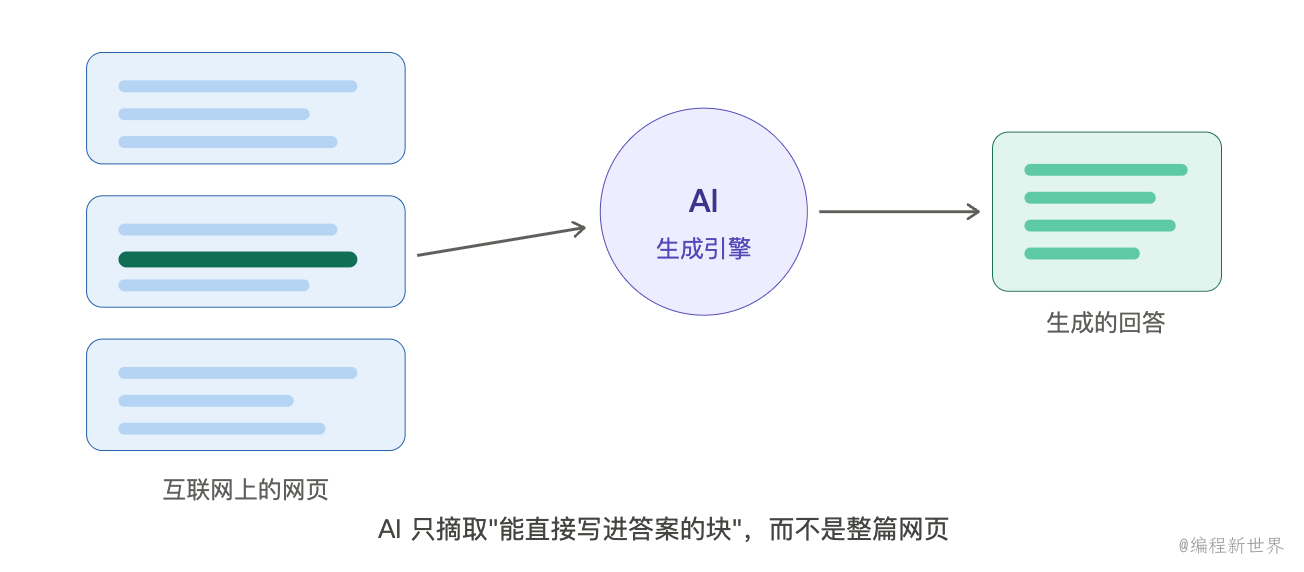
这个过程有两个关键点,直接决定了我们该怎么做。
第一,它摘取的是"块",不是"篇"。 AI不会通读你的网页再帮你总结,它只会挑出那些抄下来就能直接用进答案的句子。所以GEO拼的不是搜索排名,而是内容好不好"被抄"。
**第二,它得先"看得到"你的网站。**如果连门都进不来,写得再好也是白搭。
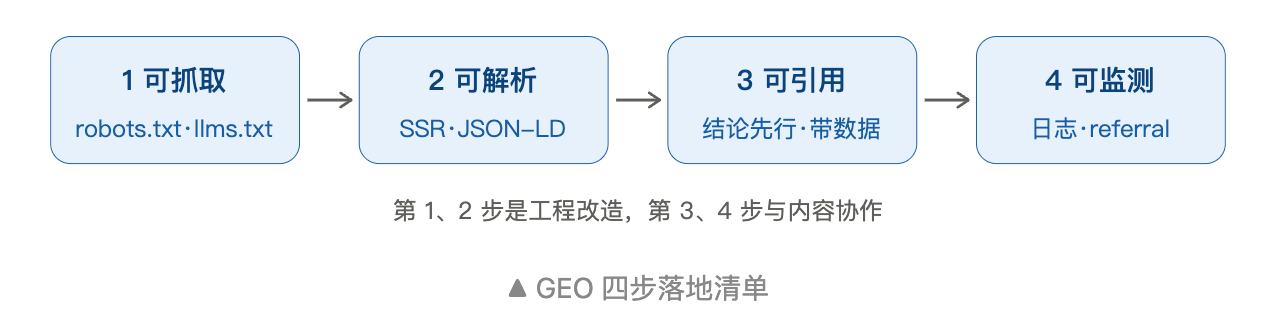
想通这两点,改造路线就清晰了,一共四步。
第一步:可抓取——先把门打开
很多网站的robots.txt里躺着这样一行配置:
# 一刀切:AI 爬虫全被拦在门外
User-agent: *
Disallow: /
防住了恶意爬虫,也顺手防住了GPTBot、ClaudeBot、PerplexityBot这些AI爬虫。相当于考试前把教材锁进保险柜,然后在考场里问:为什么没人引用我的观点?
改成这样,把主流AI爬虫单独放行:
# 单独放行主流 AI 爬虫
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /
再在网站根目录放一份llms.txt,用Markdown把站内核心文档的入口列个清单,很多AI引擎已经开始优先读这份文件。
顺便说个上周的行业新动向:OpenAI、谷歌、微软、Anthropic四家刚共同推了一个**"统一退出"标准**,以后在robots.txt里配置一次,就能同时向所有大厂声明"我的内容允不允许用于AI训练"。注意,被AI引用和被AI拿去训练是两个开关,先想清楚要不要下场,再琢磨怎么被引用。
第二步:可解析——AI爬虫不执行JavaScript
把AI爬虫想象成一台关掉了JavaScript的极简浏览器。如果你的网站是纯前端渲染的单页应用,内容全靠浏览器现画,那它在AI眼里就是一个漂亮的空壳。
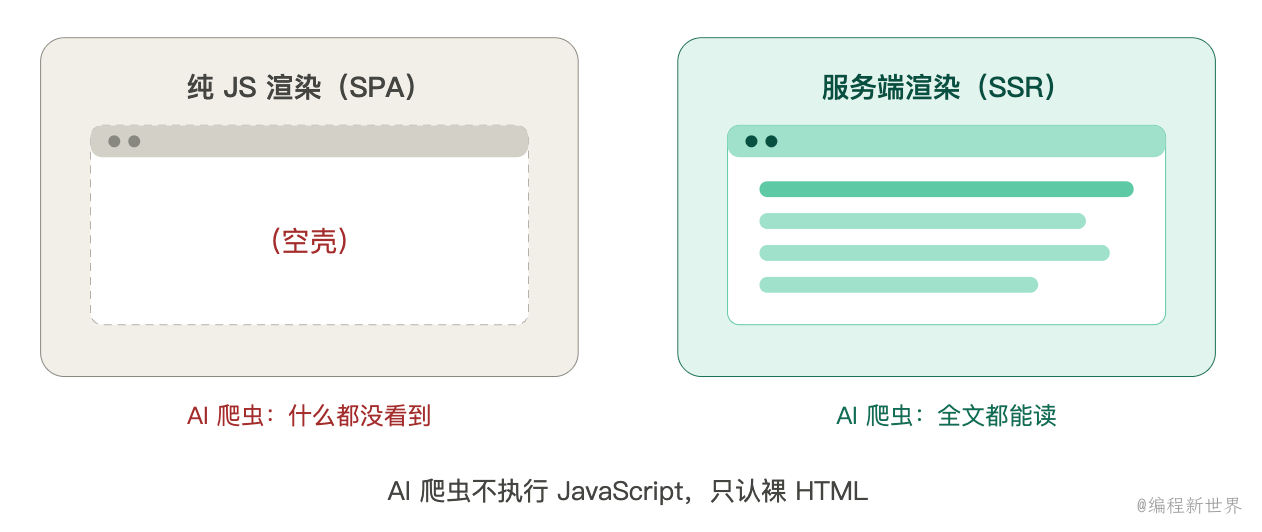
改造要点:
- 内容走SSR或静态生成,保证不执行JS也能读全文;
- HTML用语义化标签,标题层级老老实实排好,URL稳定规范;
- 往页面里嵌JSON-LD结构化数据,FAQPage、HowTo、Article三种性价比最高;
- 文档站有条件的话,加个Markdown版本路由,AI读起来更省事。
第三步:可引用——写成能被抄的答案块
这一步最能看出GEO和传统SEO的区别。看两段写法的对比:
✕ 差的写法:"我们的网关功能强大,性能优异,深受客户好评。"
——全是形容词,AI抄走这段什么都答不了。
✓ 好的写法:"XX网关单节点支持5万QPS,P99延迟低于20毫秒(2026年10月压测数据)。"
——结论先行、带具体数字和来源,AI抄走这一段,就能直接回答用户的性能问题。
规律很简单:每段开头直接给结论,关键论断带数据、来源和更新日期。FAQ和对比表格,是AI最爱引用的两种形态。
第四步:可监测——闭环才有优化
改造不是一锤子买卖,还得知道效果:
- 日志里把AI爬虫的UA单独统计,看它们来了多少次、抓了哪些页面;
- 统计来自chatgpt.com、perplexity.ai等AI产品的referral流量;
- 每隔一阵亲自去问AI几个行业问题,看它有没有引用你、引述得对不对,不对就回头改。
总结
GEO对程序员来说就是四件事:放行爬虫、裸HTML可读、内容写成能被抄的答案块、建一套监测闭环。第1、2步是纯工程改造,一次做对长期受益;第3、4步需要和内容同学搭伙干活,但方法论都在上面了。
最后,回到开头那个一分钟自测:去问问AI你的领域它提不提你。测完欢迎回来评论区报个数,让更多人知道"AI可见性"这回事。觉得有用的话,点个**"在看"**,转给你那个网站还是SPA的朋友。
评论
发表评论