Free Claude Code:多个AI编程Agent终于能共用一个模型入口
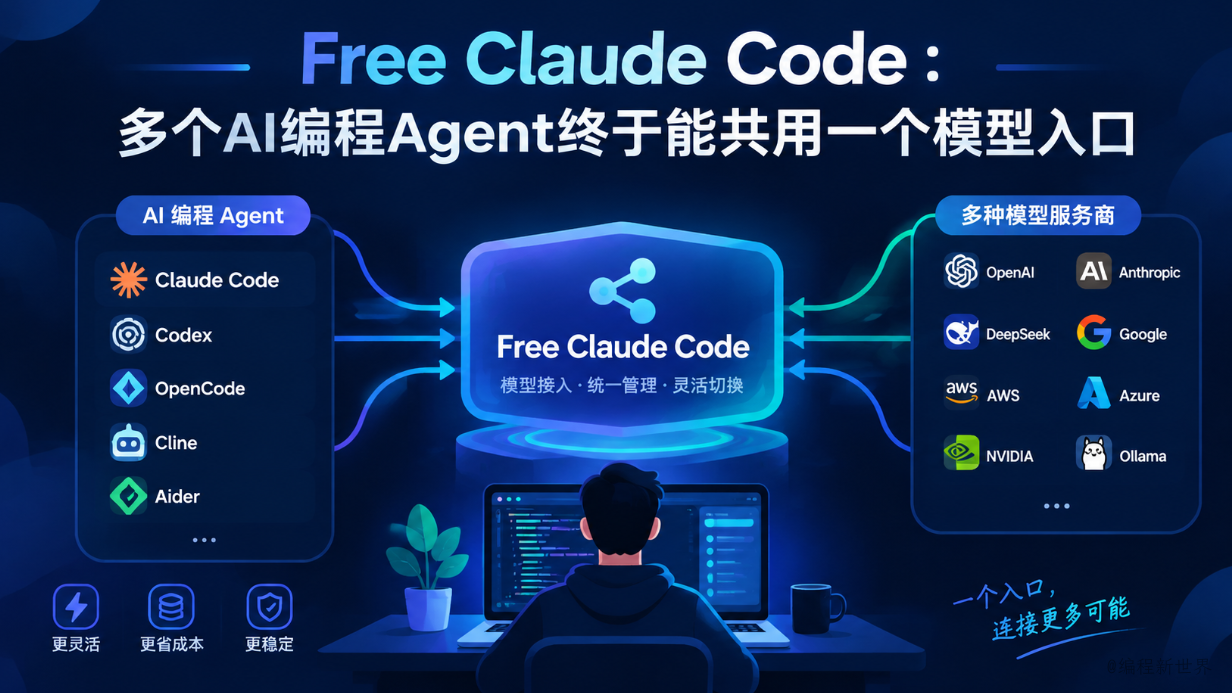
一、AI 编程工具越来越多,真正的麻烦是什么?
这两年,程序员使用 AI 编程的方式发生了明显变化。
以前,我们习惯在 IDE 里写代码,遇到问题再问 AI;现在,越来越多开发者开始使用 Claude Code、Codex、OpenCode 这类编程 Agent,让 AI 直接理解项目、修改文件、运行命令,甚至参与整个开发流程。
但工具用得越多,新的问题也逐渐暴露出来。
第一,模型和工具之间存在割裂。
你可能喜欢 Claude Code 的工作流,又想试试其他模型的代码能力;也可能已经在使用 Codex,却希望在某些任务中换一个模型。
不同工具往往有各自的配置方式、模型入口和账号体系。
第二,免费额度并不稳定。
有的服务提供免费模型,有的按 API 调用量收费,有的依赖订阅计划,还有一些开发者会在本地运行模型。
问题在于,免费额度可能有速率限制、每日上限或临时调整。今天能用的模型,明天不一定还能稳定使用。
第三,切换模型的成本不低。
当一个模型达到额度上限,或者服务暂时不可用时,开发者可能需要重新配置客户端、切换账号,甚至更换整个工作流。
于是,一个值得关注的方向出现了:
能不能把编程 Agent 和模型服务分开管理,让前者继续负责理解代码、调用工具和执行任务,后者则可以根据需要灵活切换?
这就是 Free Claude Code 想解决的问题。
二、Free Claude Code 到底是什么?
项目地址:
https://github.com/Alishahryar1/free-claude-code
Free Claude Code,简称 FCC,是一个开源的模型代理与管理工具。
简单理解,它在编程 Agent 和模型提供商之间增加了一个统一入口。
传统使用方式可能是:
开发者 → 编程 Agent → 某个模型服务
接入 FCC 后,可以变成:
开发者 → 编程 Agent → FCC → 云端模型 / 免费模型 / 本地模型
这样一来,编程 Agent 和模型服务不必始终绑定在一起。开发者可以通过 FCC 的管理界面配置提供商、选择模型,并根据需要设置备用模型。
需要注意:FCC 不会凭空创造免费算力,也不会让付费模型自动变成免费模型。 它的价值在于整合入口、简化切换和管理;实际可用额度仍然取决于各个模型服务商。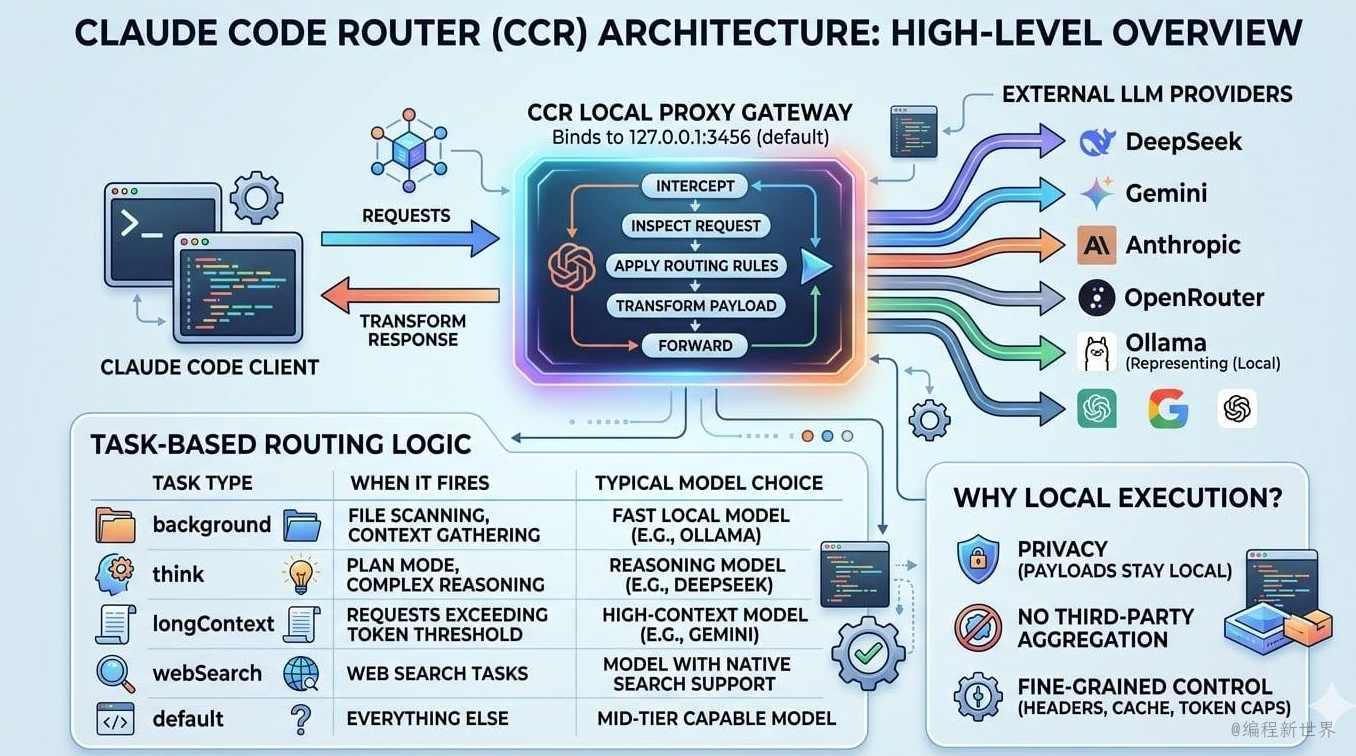
三、它有哪些值得关注的功能?
1. 一个入口连接多种编程
Agent按照项目 README,目前 FCC 支持 Claude Code、Codex、Pi、OpenCode、Cline、Hermes、DeepSeek Harness、Grok Build、Muse Code、Aider,以及 VS Code Chat 等工具或客户端。
这意味着,开发者不必把全部工作流押在某一个编程 Agent 上。
例如:
- 使用 Claude Code 完成复杂的代码重构。
- 使用 Codex 处理另一个项目中的开发任务。
- 使用 OpenCode 探索不同模型的编码效果。
- 在支持的 IDE 集成中继续原有的开发流程。
实际支持情况、安装要求和各客户端的兼容性,应以项目当前版本为准。
2. 统一管理不同模型提供商
FCC 可以配置多个模型服务来源,包括部分免费模型、付费 API、订阅类接入方式以及本地模型。
开发者可以在管理界面配置服务商,再从模型列表中选择目标模型。
举个例子:
日常代码解释、生成测试用例,可以优先尝试成本较低的模型;复杂重构、疑难 Bug 排查,则可以切换到自己认为更可靠的模型。
这里的关键不是“哪个模型永远最好”,而是让模型选择更贴近任务本身。
3. 支持备用模型,减少单一服务中断的影响
FCC 支持配置有序的备用模型列表。
当当前模型请求失败,并且相关重试结束后,工具可以按照配置尝试后续模型,减少开发者手动切换的次数。
但要注意两个细节:
第一,备用模型需要提前配置,而且并不是所有失败都一定能够通过切换解决。
第二,失败请求可能已经消耗某个服务商的额度,后续备用模型也可能产生新的用量。因此,备用模型不等于无限免费,也不等于所有任务都能无感切换。
4. 支持多种开发入口
除了终端,项目还提供不同客户端及 IDE 集成方向,并支持浏览器中的原生 Codex 会话等能力。
对于习惯终端工作的开发者,这意味着可以继续使用自己熟悉的编程 Agent;对于希望通过图形界面管理配置的人,管理 UI 也能降低一部分配置门槛。
它的定位不是取代 IDE,而是让模型接入和切换更灵活。
四、怎么安装和使用?
以实际操作为例
如果你准备尝试,建议先从最简单的方式开始,不要一上来就配置一堆模型和插件。
第一步:打开项目仓库
访问:
https://github.com/Alishahryar1/free-claude-code
先阅读 README,确认当前版本支持的操作系统、安装方式、客户端及模型提供商。
尤其要注意:项目安装脚本会在本机执行操作。
正式运行之前,建议先查看脚本内容,了解它会安装哪些组件、修改哪些配置。
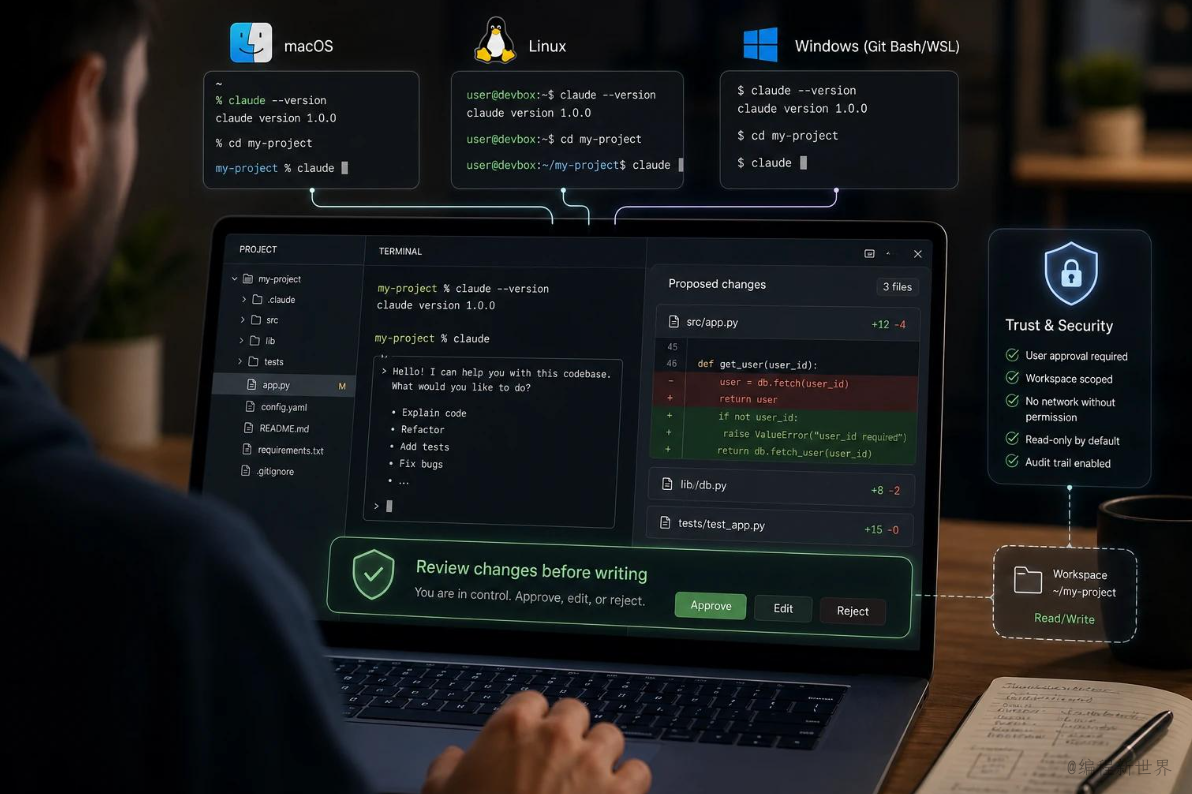
第二步:根据操作系统安装
macOS / Linux 可以参考项目当前 README 提供的安装命令:curl -fsSL "https://raw.githubusercontent.com/Alishahryar1/free-claude-code/main/scripts/install.sh" | sh
Windows PowerShell 可以使用:& ([scriptblock]::Create((irm "https://raw.githubusercontent.com/Alishahryar1/free-claude-code/main/scripts/install.ps1")))
以上命令来自项目 README。运行前应自行审查脚本,确认来源可信,并结合自己的系统环境判断是否适合执行。
安装过程中,根据提示选择至少一个希望使用的编程 Agent。其他可选组件可以等基本功能验证成功后再添加。
第三步:启动 FCCWindows 和 macOS
可以根据安装结果,从桌面、开始菜单或应用程序入口启动。
Linux 则可以按项目说明运行:fcc-server
启动后,按照终端输出或应用入口打开管理界面。
管理界面是后续配置模型的主要入口。
具体地址、启动方式和菜单名称可能随版本调整,以实际界面为准。
第四步:配置模型提供商
进入管理界面,找到 Providers 相关配置。
接下来选择一个自己能够合法使用的模型服务,例如支持的免费模型服务、付费 API,或本地模型。
一般流程是:
- 按服务商要求获取 API Key,或者完成支持的账号授权。
- 在 FCC 中配置对应的服务商。
- 从模型列表中选择目标模型。
- 在模型配置中应用设置。
- 启动或重新启动相应客户端,验证模型是否能够正常响应。
不同服务商的配置方式不完全相同。有的需要 API Key,有的使用 OAuth 或账号授权,还有的需要指定模型 ID 和服务地址。
不要把 API Key 直接写进公开代码仓库,也不要把密钥发给不可信的第三方。
第五步:启动编程 Agent
根据项目 README,可以使用对应的启动命令,例如:
fcc-claude
或者:
fcc-codex
也可以根据安装和配置情况选择其他支持的客户端。
启动后,先执行一个简单任务,例如让 AI 解释某个函数、补充单元测试,或者修改一个独立的小模块。
确认以下环节正常工作后,再开始真实项目开发:
- Agent 能否正常启动。
- 当前选择的模型能否正常响应。
- 工具调用和代码修改是否正常。
- 模型额度或请求失败时,日志是否有清晰提示。
- 切换模型后,任务效果是否发生明显变化。
第一次使用,不建议直接让 AI 修改整个生产项目。
五、哪些场景适合使用 FCC?
工具有没有价值,最终还是要看它能不能解决实际问题。
场景一:想尝试多个模型,但不想反复改配置
这是 FCC 比较直观的使用场景。
例如,你正在使用一个编程 Agent,希望比较不同模型在代码生成、问题定位和重构方面的表现。
通过统一入口配置模型后,可以在同一类任务中更方便地比较不同方案,而不必每次都从头搭建接入环境。
适合人群:喜欢折腾工具、经常测试新模型、希望建立模型评测流程的开发者。
场景二:希望降低日常 AI 编程成本
对于个人开发者和小团队来说,AI 编程的成本不只体现在订阅费上,还包括 API 调用量、重复试错,以及低价值任务占用的高价模型额度。
可以尝试建立一套简单的分层策略:
- 代码解释、基础文档和简单测试:优先使用成本较低的模型。
- 普通功能开发:根据实际效果选择性价比较好的模型。
- 复杂重构、疑难 Bug 和关键架构问题:优先使用经过验证、能力更适合的模型。
FCC 能让模型切换和管理更方便,但是否真的省钱,仍需要结合实际调用量、服务商计费方式和任务成功率来计算。
不要只看单次调用价格,还要看完成一个任务总共花了多少钱。
场景三:免费模型额度用完后,希望减少手动切换
假设你配置了模型 A 和模型 B。
日常工作优先使用 A;如果请求失败,且备用模型配置正确,FCC 可以按顺序尝试 B。
这种方式有机会减少中断对工作流的影响。
但如果两个模型都达到限制,或者它们无法完成同一种工具调用,任务仍然可能失败。
所以更合理的做法是:将备用模型当作容错机制,而不是把它视为稳定无限的免费资源。
场景四:希望在本地模型和云端模型之间灵活选择
一些开发者希望在本地运行模型,减少数据发送到外部服务的情况;
另一些任务则更依赖云端模型的能力。
FCC 支持的模型接入方式中包含本地模型相关选项,具体能否使用取决于模型、运行环境及配置。
需要特别强调:使用本地模型,不代表整个开发链路自动具备隐私保障。
还应检查 Agent 的工具权限、日志、插件、网络访问和数据处理方式。
只有把整个链路梳理清楚,才能判断哪些数据真正留在本地。
六、程序员使用这类工具,应该注意什么?
工具本身不是重点,如何把它放进开发流程才是重点。
建议一:不要把“免费”当作唯一标准
很多开发者看到“免费 Token”,第一反应就是赶紧安装。
但真正需要考虑的是:模型能不能完成任务?额度是否稳定?响应速度如何?工具调用是否兼容?失败后有没有备用方案?
如果一个免费模型反复生成错误代码,需要花大量时间纠正,那么它节省的费用,很可能被调试时间抵消。
建议用自己的真实项目进行测试,而不是只看宣传页中的模型榜单。
建议二:先建立自己的模型评测标准
不要因为某个模型在社交平台上很火,就认定它适合自己的项目。
可以准备一组固定任务,例如:
- 为一个已有函数补充单元测试。
- 修复一个可以复现的 Bug。
- 阅读一个模块并梳理调用关系。
- 按照现有架构增加一个小功能。
- 重构一段代码,同时保证测试通过。
让不同模型完成相同任务,再比较正确性、修改范围、测试结果、响应时间和总成本。
这样得到的结论,才真正对自己的开发工作有价值。
建议三:把模型切换与代码质量控制分开
模型切换解决的是“谁来生成代码”,并不能保证代码一定正确。
无论使用哪个模型,都应该保留基本的工程纪律:
- 使用 Git 管理变更。
- 修改前检查工作区状态。
- 关键改动先看 diff,再决定是否接受。
- 通过自动化测试和代码检查验证结果。
- 对数据库迁移、权限控制、支付等关键逻辑进行人工审查。
如果让 AI 自主修改代码,却没有测试和审查机制,那么切换再多模型,也无法从根本上解决质量问题。
建议四:谨慎处理密钥、源码和公司数据
这点尤其重要。
在配置模型提供商时,可能需要输入 API Key、账号授权信息,或者设置自定义服务地址。
在公司环境中使用之前,建议确认:
- 安装脚本和依赖来源是否可信。
- 密钥是否会被写入日志或配置文件。
- 管理界面和代理服务是否暴露给不可信的网络。
- 请求内容会发送给哪些模型提供商。
- 供应商是否允许当前用途,是否符合公司的数据合规要求。
- 是否需要启用代理认证或限制访问范围。
对于公司项目,不要因为工具支持某种接入方式,就默认它符合企业的安全和合规要求。
建议五:把时间花在工作流上,而不是无限折腾工具
工具链越丰富,越容易陷入一个误区:每天都在研究新工具,却没有真正提高交付效率。
建议先固定一套能稳定工作的开发流程:需求分析 → 任务拆分 → AI 辅助实现 → 自动化测试 → 人工审查 → 提交代码
在这套流程稳定后,再逐步引入模型切换、备用路由、Token 优化等能力。
好的工具链应该减少开发者的决策成本,而不是增加一套需要长期维护的复杂系统。
七、最后总结:它值得尝试,但别把它当成万能方案
Free Claude Code 值得关注的地方,不是它宣称能够接入多少免费 Token,而是它试图把编程 Agent 和模型服务之间的关系变得更灵活。
对个人开发者来说,它可以作为体验多种模型、管理不同接入方式的工具。
对技术团队来说,它提供了一个探索统一模型入口、备用模型和成本管理的思路,但在正式使用前仍然需要评估安全、稳定性、合规性和维护成本。
如果你目前只有一套稳定的 AI 编程环境,而且使用体验很好,没有必要为了追求工具数量而强行迁移。
但如果你经常测试不同模型、需要在多种编程 Agent 之间切换,或者希望更清楚地管理模型使用成本,那么可以考虑在独立测试项目中试一试。
最后送给程序员一句话:
不要为了免费而牺牲效率,也不要为了追求最强模型而忽视成本。真正值得追求的,是让合适的模型,在合适的任务中,以可控的成本,稳定地交付可验证的代码。
项目地址:https://github.com/Alishahryar1/free-claude-code
说明:本文基于项目公开 README 整理。功能、支持的客户端和模型服务商、安装命令及免费额度均可能变化,请以项目仓库和各服务商的最新说明为准。Free Claude Code 是独立开源项目,并非 Anthropic 官方产品。
评论
发表评论