DeepSeek 又崩了!近3小时没恢复,真要憋大招?
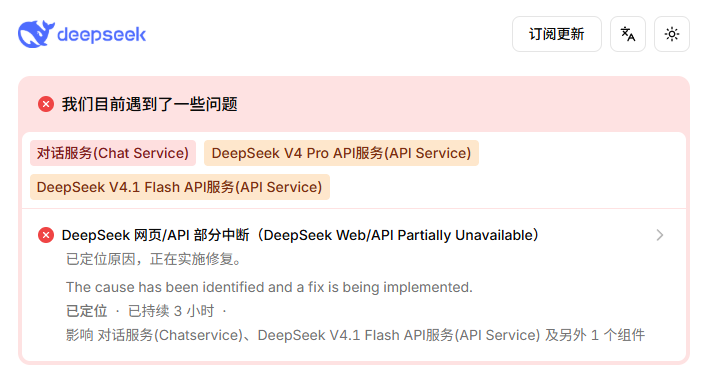
这次不是问一句话转半天,也不是偶尔报个错。
如果你今天打开 DeepSeek,发现对话迟迟没有响应,甚至 API 调用也受到影响,那估计已经感受到这波异常的威力了。
更让人揪心的是,按照目前反馈的情况,故障已经持续了接近 3 个小时,从早上八点开始到现在还没恢复。
这就有意思了。
放在以前,AI 服务出故障,大家第一反应通常是:服务器又扛不住了?
但到了 DeepSeek 这里,画风却逐渐变成了:
“又崩了?难道又要发新模型了?”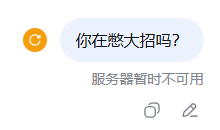
好家伙,服务器还没恢复,网友已经开始替研发团队安排发布会了。
那么问题来了:这次 DeepSeek 到底是遇到了普通的技术故障,还是正在为下一代模型做准备?
咱们不妨拆开看看。
一、连续故障近3小时,问题究竟出在哪?
先说结论:服务异常可以确认,但具体根因不能靠猜。
AI 服务看起来只是一个聊天框,背后却是一整套复杂的技术系统。
从用户发出问题,到模型返回答案,中间可能涉及请求接入、流量调度、推理集群、缓存、网络通信等多个环节。
任何一个关键环节出现问题,都可能影响最终体验。
尤其是大模型服务,和普通网站还不太一样。
普通网站访问量突然增加,可能只是页面打开变慢;大模型服务一旦遇到容量不足、推理节点异常或调度故障,用户可能直接面临请求超时、生成中断,甚至完全无法使用。
当然,这些只是可能的技术原因,并不代表 DeepSeek 此次故障已经确认由其中某一项引起。
还有一种可能是后台维护、系统变更或发布过程中的异常。
但这里必须强调一句:目前没有充分证据证明,这次长时间故障就是因为 DeepSeek 正在升级模型。
所以,先别急着给研发团队加戏。
真相还得看官方后续怎么说。
二、为什么 DeepSeek 一出故障,大家就怀疑要发新模型?
这个现象其实挺有意思。
换成其他软件,服务宕机,用户最关心的是什么时候恢复。
到了 DeepSeek 这里,除了催修复,还有一群人开始猜测:
是不是新模型快来了?
这种联想并不是完全没有背景。
过去几年,DeepSeek 已经在开源模型、推理能力和模型效率等方面积累了相当高的关注度。每当它出现新的技术进展,都会引发开发者社区的广泛讨论。
对于长期关注国产大模型的人来说,DeepSeek 的每一次异常、每一次动态,都可能让人联想到下一次技术更新。
但这里有一个很容易被忽略的问题:
大家期待新模型,不代表每一次服务故障都与新模型有关。
服务器异常和模型发布,是两件不同的事情。
模型发布可能涉及新权重、新版本、新 API 能力或基础设施调整;而服务故障也可能只是一次普通的系统问题。
除非官方公告、模型仓库更新、API 文档变化或其他可靠信息能够形成证据链,否则,仅凭服务不可用的持续时间,无法判断新模型是否即将发布。
说白了,大家可以猜,但不能把猜测当成实锤。
三、如果不是憋大招,这次故障又说明了什么?
其实,比起猜测 DeepSeek 会不会发布新模型,我更关心另外三个问题。
1. 服务稳定性,已经成为大模型竞争的重要指标
对于普通用户来说,AI 偶尔出错,可能只是影响一次对话。
但对于开发者而言,情况完全不同。
如果一个项目把模型 API 接入了生产环境,服务中断就可能意味着业务流程受阻、任务执行失败,甚至影响整个应用的正常运行。
模型能力再强,如果关键时刻无法调用,也会影响实际使用价值。
因此,大模型之间的竞争,早已不只是回答得准不准、跑分高不高。
还包括服务稳定性、响应速度、调用成本、并发能力,以及故障恢复速度。
能回答问题是基本功,能持续稳定地回答问题,才是服务真正进入生产环境的门槛。
2. 开发者不能把所有业务都押在一个模型上
这次故障也给开发者提了个醒。
如果你的产品高度依赖单一模型服务,那么一旦上游出现问题,你的应用可能跟着停摆。
比较稳妥的做法,是提前设计好异常处理机制。
例如:
- 为请求设置合理的超时时间和重试策略,避免失败请求无限等待。
- 对关键业务设计降级方案,在主模型不可用时切换到备用模型。
- 监控 API 错误率、响应延迟和服务状态,及时发现异常。
- 对重要任务设置队列、断点续跑或结果持久化机制,减少故障造成的损失。
当然,不是所有项目都需要一上来就搞复杂的多模型架构。
但对于依赖 AI 完成核心业务的应用来说,至少应该想清楚一个问题:
如果主模型突然挂了,你的系统还能不能继续工作?
这比每天追着模型排行榜看,可能更有实际价值。
3. 真正值得关注的,是故障之后出现了什么
如果想判断 DeepSeek 是否有新动作,与其反复刷新聊天页面,不如观察几个更有价值的信号。
**第一,**看官方服务状态页有没有进一步披露故障原因、影响范围和恢复情况。
**第二,**看官方是否发布新的模型公告,或者模型仓库是否出现经过确认的版本更新。
**第三,**看 API 文档、模型名称、调用参数等信息是否发生正式变化。
**第四,**看修复之后,官方是否对服务架构、模型能力或产品功能作出说明。
这些信息比单纯的宕机时长更有判断价值。
即使后续真的出现新模型,也不能倒推这次故障必然是为新模型做准备。
技术问题就是技术问题,新模型发布就是新模型发布。两者之间是否有关联,需要证据说话。
四、那么,DeepSeek 这次到底会不会放大招?
说实话,现在谁也不能只凭这次故障给出确定答案。
如果接下来官方公布新模型,那当然值得关注。
如果最后确认只是基础设施或服务端故障,也完全正常。
我们没必要因为期待国产大模型进步,就把每一次异常都解释成重大升级的前奏。
但反过来说,大家对 DeepSeek 的关注,也说明它已经不只是一个普通的聊天工具。
对于很多开发者来说,它是日常工作流的一部分;对于整个国产大模型行业来说,它的技术进展也会影响大家对开源模型能力和应用前景的判断。
所以,这次故障真正值得关注的,不只是它什么时候恢复。
还包括官方如何解释问题、服务多久能够稳定,以及后续有没有可以验证的新技术进展。
至于大家最期待的那个问题——新模型到底什么时候来?
咱们先不替官方剧透。
毕竟,服务器可以暂时掉线,猜测不能直接升级成新闻。
最后问一句:
如果 DeepSeek 明天真的发布新模型,你觉得它最应该优先提升什么?
A. 推理能力,再把复杂问题想得更透彻。
B. 编程能力,让开发者写代码、修 Bug 更省心。
C. API 稳定性,别动不动就让开发者等恢复。
D. 推理成本,让更多应用真正用得起。
评论区聊聊。比起猜它是不是在憋大招,我更想看看大家究竟希望 DeepSeek 下一步把力气花在哪里。
评论
发表评论